Bài 8/12 trong chuỗi Kinh tế Vibe Coding
Có một tình huống khá trớ trêu trong việc viết lách kỹ thuật: những lời khuyên nghe rất sáng suốt khi viết ra giấy lại chưa chắc là thứ chính tác giả làm theo khi ngồi vào bàn làm việc thật.
Trong lời khuyên tôi viết cách đây một tháng, tôi từng phân tích rằng mô hình tầm trung như Claude Sonnet làm tốt phần lớn việc lập trình hằng ngày, và người dùng nên để dành mô hình mạnh nhất như Claude Opus cho quyết định kiến trúc. Lập luận đó có căn cứ từ tài liệu chính thức của Anthropic, đi kèm phép so sánh trực quan về chuyện không nên thuê chuyên gia chiến lược chỉ để đi dán nhãn phong bì.
Nhưng khi tôi trích xuất dữ liệu thực tế từ 62 phiên làm việc của chính mình trên dự án này, sự thật hiện ra hoàn toàn ngược lại: tôi đã dùng gần như toàn bộ lượt tương tác cho chính mô hình mạnh nhất mà mình từng khuyên nên tiết chế.
Lời khuyên tôi viết cách đây một tháng
Nhìn lại bài viết trước, cơ sở lý luận cho lời khuyên chọn model tầm trung hoàn toàn không sai.
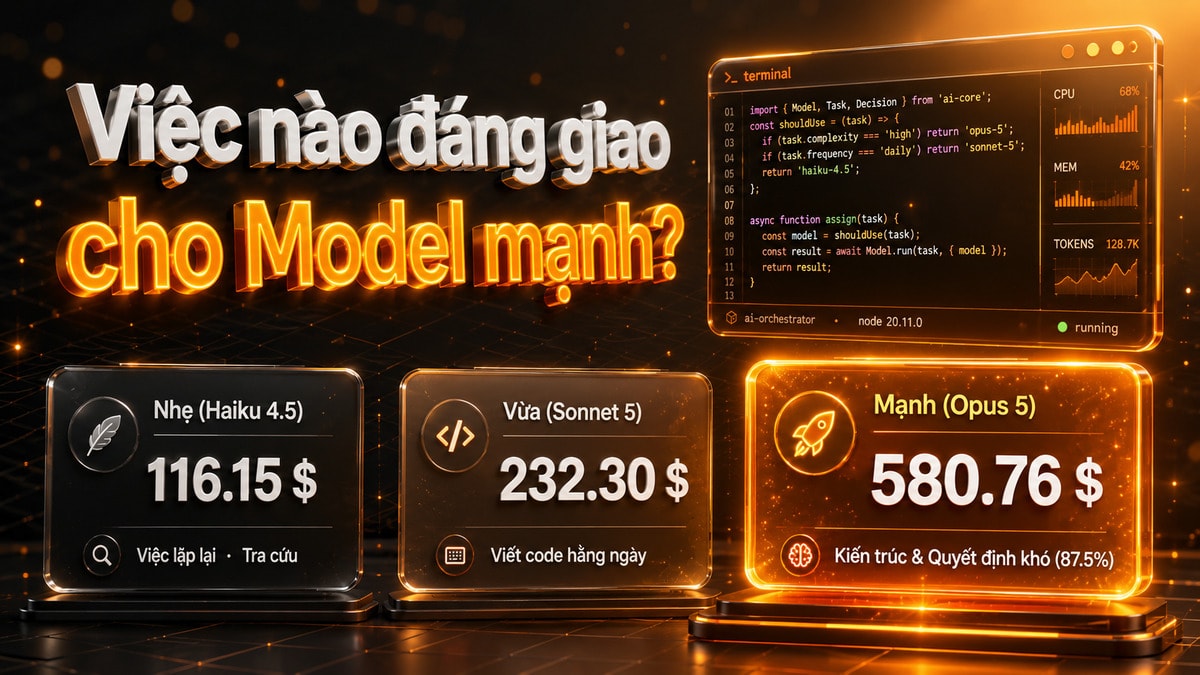
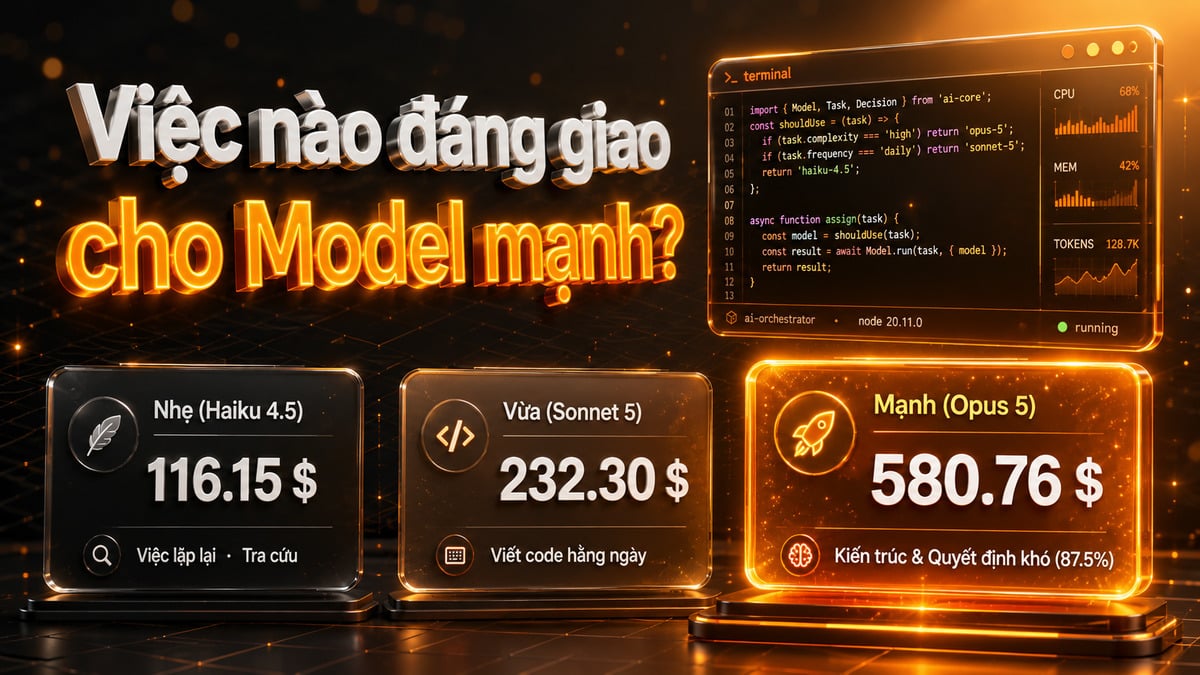
Các nhà cung cấp luôn phân cấp mô hình thành ba bậc: bậc nhẹ (như Haiku) cho việc máy móc tra cứu, bậc vừa (như Sonnet) cho việc viết mã hằng ngày, và bậc mạnh (như Opus) cho bài toán kiến trúc cùng quy trình đa bước phức tạp. Tài liệu của Anthropic cũng nhấn mạnh rằng Sonnet đủ sức đảm nhận phần lớn tác vụ lập trình với chất lượng tương đương nhưng chi phí thấp hơn đáng kể.
Tôi từng viết rằng mặc định chọn model mạnh nhất cho mọi câu lệnh giống như phản xạ chọn cấu hình máy tính — nghĩ rằng mạnh hơn thì luôn tốt hơn. Giao việc dán phong bì cho chuyên gia chiến lược thì bạn không nhận được phong bì dán đẹp hơn, bạn chỉ trả nhiều tiền hơn cho cùng một chồng phong bì. Bài viết đó cũng nhắc mức độ suy nghĩ tính tiền như phần trả lời, nên bật model lớn kèm suy nghĩ sâu cho việc vặt là sự lãng phí kép.
Đó là lời khuyên hoàn chỉnh về logic và được nhiều người đồng tình. Vấn đề duy nhất là khi bước vào dự án thực tế, chính tôi lại không làm như vậy.
Số đo nói tôi làm ngược lại
Khi đo đạc lại toàn bộ 4.794 lượt gọi trong 62 phiên làm việc, bảng phân bổ mô hình thực tế lộ ra bức tranh hoàn toàn lệch:
Claude Opus 5 chiếm 4.592 lượt, tương đương 95,79% tổng số lượt gọi.
Claude Opus 4.8 chiếm 141 lượt, tương đương 2,94%.
Claude Fable 5 chiếm 25 lượt, tương đương 0,52%.
Và Claude Sonnet 5 — mô hình tôi từng khuyên dùng cho phần lớn công việc — chỉ xuất hiện đúng 36 lượt, tương đương 0,75%.
Thay vì dùng Sonnet cho 80% công việc và giữ Opus cho 20% bài toán khó, tôi đã chạy tới hơn 95% số lượt trên chính mô hình đắt đỏ nhất.
Sự lệch pha này không phải do tôi quên chuyển model hay chọn nhầm cấu hình. Khi đứng trước dòng lệnh và chịu áp lực hoàn thành công việc thật, tôi liên tục chọn Opus. Và lựa chọn đó đi kèm cái giá cụ thể bằng tiền mặt.
Cùng lượng việc đó trên model rẻ hơn tốn bao nhiêu
Để thấy rõ khoảng cách chi phí, tôi lấy toàn bộ lượng token mà 4.592 lượt Claude Opus 5 tiêu thụ và tính toán lại xem nếu chạy trên các mô hình khác thì tổng số tiền là bao nhiêu.
Theo bảng giá, chênh lệch giữa các bậc mô hình là rất lớn:
Với Claude Opus 5, giá input là 5 $, đọc cache 0,5 $, ghi cache bậc 1 giờ 10 $, và output 25 $ mỗi triệu token. Tổng chi phí quy đổi cho 4.592 lượt này là 720,18 $.
Với Claude Sonnet 5, giá input là 2 $, đọc cache 0,2 $, ghi cache 1 giờ 4 $, và output 10 $ mỗi triệu token. Cùng lượng token đó ở Sonnet 5 chỉ tốn 288,07 $.
Với Claude Haiku 4.5, giá input là 1 $, đọc cache 0,1 $, ghi cache 1 giờ 2 $, và output 5 $ mỗi triệu token. Cùng lượng token đó trên Haiku 4.5 chỉ tốn 144,04 $.
Chênh lệch là rất rõ ràng: nếu chuyển toàn bộ từ Opus 5 sang Sonnet 5, tôi đã có thể tiết kiệm 432,11 $ (từ 720,18 $ xuống 288,07 $). Còn nếu chuyển sang Haiku 4.5, mức tiết kiệm là 576,14 $.
Một điểm cần nói rõ: thực tế trong quá trình làm dự án, tôi dùng gói thuê bao trả phí hằng tháng chứ không trả theo hóa đơn API như bảng tính trên. Tuy nhiên, vì nhà cung cấp công bố cửa sổ reset của gói thuê bao mà không công bố hạn mức đó lớn bao nhiêu tính bằng token, rất khó so sánh định lượng, tôi dùng bảng giá API làm thước đo chuẩn để bạn dễ hình dung sự chênh lệch chi phí giữa các mô hình.
Khoản chênh lệch hơn 430 đô la đủ lớn để bất kỳ ai cũng phải tự hỏi: tại sao tôi vẫn chấp nhận trả số tiền đó mà không đổi sang model rẻ hơn?
Ba công cụ khác nhau trên cùng một repo
Bảng trên chỉ có một cột, vì nó so Opus 5 với chính nó chạy trên biểu giá khác. Nhưng dự án này không chỉ có Claude. Tôi chạy song song ba công cụ, và khi bóc nhật ký của cả ba thì bức tranh phân bổ công việc mới hiện đủ.
Claude Code chạy 62 phiên với 4.794 lượt gọi và 946.786.932 token. Codex chạy 29 phiên với 3.188 lượt gọi và 437.691.606 token. Antigravity chạy 54 phiên với khoảng 5.874 lượt gọi.
Hai con số đầu là số đo trực tiếp: cả Claude Code lẫn Codex đều ghi thẳng lượng token của từng lượt vào nhật ký trên máy. Con số thứ ba thì không. Antigravity lưu hội thoại dưới dạng cơ sở dữ liệu mã hoá và không ghi bất kỳ trường token nào, nên tôi chỉ đếm được số lượt rồi ước ra khoảng 806 triệu đến 1.152 triệu token. Tôi để nguyên nó ở dạng một khoảng, vì chốt một con số cho gọn bảng là bịa.
Điều đáng chú ý là hình dạng chi phí của Codex gần như trùng khít với Claude: 95,77% token phía input của nó cũng là token đọc lại từ cache. Quy luật ngữ cảnh nuốt hết hóa đơn không phải đặc thù của một nhà cung cấp nào cả.
Chỗ khác nhau nằm ở vai. Antigravity gánh nhiều lượt gọi nhất nhưng làm phần việc kiểm chứng được bằng một lệnh chạy. Claude Code gánh ít lượt hơn nhưng làm phần cần phán đoán. Cách chia đó là chủ đề của bài về phân luồng nhiều agent.
Vì sao tôi vẫn không đổi
Câu trả lời không nằm ở việc so sánh đơn giá token, mà nằm ở đơn vị kinh tế cốt lõi: chi phí cho mỗi tác vụ được chấp nhận.
Khi so sánh 720,18 $ của Opus 5 với 288,07 $ của Sonnet 5, chúng ta ngầm giả định: cả hai mô hình đều hoàn thành công việc với số lượt gọi và độ chính xác y như nhau.
Nhưng trong thực tế, giả định đó hiếm khi đúng.
Khi một mô hình rẻ hơn hiểu sai một chi tiết kiến trúc, sửa nhầm hàm phụ thuộc, hoặc sinh mã không vượt qua bài kiểm thử, bạn phải can thiệp để yêu cầu làm lại. Mỗi vòng sửa sai đó không chỉ tốn vài token output mới. Mỗi lượt gọi mới bắt buộc phải cõng theo toàn bộ ngữ cảnh khổng lồ của cả phiên — chính là dòng chi phí lớn nhất của hệ thống.
Một lần làm lại kéo theo hàng chục nghìn token đọc cache và ghi cache có thể xóa sạch số tiền bạn vừa tiết kiệm từ đơn giá token rẻ hơn. Bạn tiết kiệm vài cent trên mỗi triệu token, nhưng lại trả thêm vài chục cent cho lượt gọi sửa sai không đáng có.
Tôi phải nói thẳng: đây là lời giải thích hợp lý từ trải nghiệm thực tế, chứ chưa phải kết luận có số liệu chứng minh. Trong bộ dữ liệu telemetry, các lượt gọi không gắn nhãn để bóc tách bao nhiêu lượt là làm lại và bao nhiêu lượt thành công ngay lần đầu. "Sợ phải làm lại" là lý do tôi chọn Opus, nhưng việc liệu Opus có thực sự giúp giảm số lần làm lại đủ nhiều để bù đắp chênh lệch giá hay không vẫn là điều cần đo đạc thêm.
Cách chia việc mà tôi thật sự dùng được
Sau khi nhìn thẳng vào thực tế, tôi nhận ra việc chia model không thể áp dụng máy móc.
Thực tế trong dự án này, tôi không chỉ dùng duy nhất Claude Code, tôi dùng cả Codex và Gemini trên Antigravity nữa. Tôi chia việc cho ba công cụ: Gemini - mô hình nhanh nhận phần thực thi — viết code, chạy kiểm thử, bóc tách dữ liệu và viết bản nháp theo đề bài đã chốt; Claude Code giữ phần lập kế hoạch, viết đề bài và soát kết quả; còn Codex chỉ chạm vào những việc mà Gemini làm nhưng không cho kết quả như ý. Chính vì giao cho Claude Code những bài toán đòi hỏi tầm nhìn tổng thể và quyết định quan trọng, tôi luôn ưu tiên chọn model mạnh nhất cho nó.
Cách chia việc thực tế mà tôi đang áp dụng dựa trên ba cấp độ rủi ro:
Thứ nhất là việc máy móc lặp lại: đổi tên hàng loạt biến số, chuyển đổi định dạng dữ liệu, viết hàm kiểm thử đơn giản theo mẫu, hoặc tra cứu tài liệu. Những việc này có ngữ cảnh ngắn, yêu cầu rõ ràng, và hậu quả sai sót gần như bằng không. Nhóm này dùng mô hình nhẹ như Haiku 4.5 là phù hợp nhất.
Thứ hai là việc lập trình tính năng hằng ngày: dựng giao diện theo thiết kế có sẵn, thêm trường dữ liệu vào form, viết endpoint API theo chuẩn quen thuộc. Nhóm này nên giao cho mô hình tầm trung như Sonnet 5, vì cấu trúc đã định hình sẵn và khả năng đi chệch hướng rất thấp.
Thứ ba là quyết định kiến trúc và bài toán đa bước: thiết kế luồng dữ liệu, tái cấu trúc module lõi, gỡ lỗi phức tạp liên quan nhiều tầng hệ thống, hoặc quyết định khó sửa về sau. Với nhóm này, đầu tư cho mô hình mạnh như Opus 5 là hoàn toàn xứng đáng, vì chi phí để mô hình hiểu đúng ngay từ đầu luôn rẻ hơn chi phí đi dọn dẹp hậu quả.
Để tự tính toán chi phí theo từng vai trò và mức độ retry của nhóm mình, bạn có thể dùng công cụ tính chi phí AI để nhập thông số thực tế trước khi phân bổ công việc.
📥 Tải miễn phí
Bộ Khung Repo Cho AI Agent
Điều tôi nhận ra
Thừa nhận mình không làm theo lời khuyên của chính mình mang lại một bài học quý giá:
Tối ưu hóa chi phí không phải là luôn chọn phương án có đơn giá thấp nhất. Tối ưu hóa thực sự là tìm điểm cân bằng giữa đơn giá công cụ, độ tin cậy của kết quả, và thời gian bạn bỏ ra để kiểm soát sai số.
Khi càng làm việc nhiều với các AI agent, bạn sẽ càng hiểu rõ đặc tính riêng của từng công cụ: agent nào mạnh về lập kế hoạch, agent nào nhanh về nghiên cứu, agent nào chuẩn về viết code. Từ sự thấu hiểu đó, việc phân công công việc và chuyển đổi linh hoạt giữa các mô hình sẽ trở nên tự nhiên, mượt mà và hiệu quả hơn rất nhiều.
Tôi muốn nói rõ về giới hạn của dữ liệu trong bài:
95,8% số lượt chạy trên model mạnh nhất là số của một người trên một repo, và phần lớn thời gian đó là việc kiến trúc chứ không phải gõ code — nên con số này nói về thói quen của tôi, chưa nói được rằng ai cũng đang tiêu quá tay. Cụ thể là 4.592 trên 4.794 lượt gọi của 62 phiên trên repo nguyenxuantai.com, cửa sổ nhật ký 14/07–02/09/2026; bảng gốc ở bài tổng hợp số liệu của chuỗi.
Hiểu rõ điều đó giúp bạn không gò ép mình vào công thức cố định: linh hoạt chuyển đổi giữa các mô hình theo tính chất công việc, và đừng ngần ngại dùng model mạnh khi bạn cần sự chính xác để tiết kiệm thời gian quý giá của chính mình.
Chọn model chỉ là một trong ba quyết định của tầng dự án, và nó chỉ có nghĩa sau khi tầng phiên đã được chốt. Thứ tự chốt cả ba tầng nằm ở bản đồ của cả chuỗi.