Bài 3/12 trong chuỗi Kinh tế Vibe Coding
Người mới dùng coding agent thường có phản xạ tự nhiên: mỗi lần gõ lệnh, họ dừng lại vài giây để gọt giũa từ ngữ, cố viết thật ngắn vì nghĩ gõ càng ít thì hóa đơn càng nhẹ.
Phản xạ đó nghe rất hợp lý, nhưng nó dựa trên một hình dung chưa đúng về cách agent xử lý công việc. Khi nhìn vào terminal, bạn chỉ thấy câu hỏi của mình và câu trả lời của máy. Bạn không thấy toàn bộ cỗ máy đang âm thầm chạy phía sau.
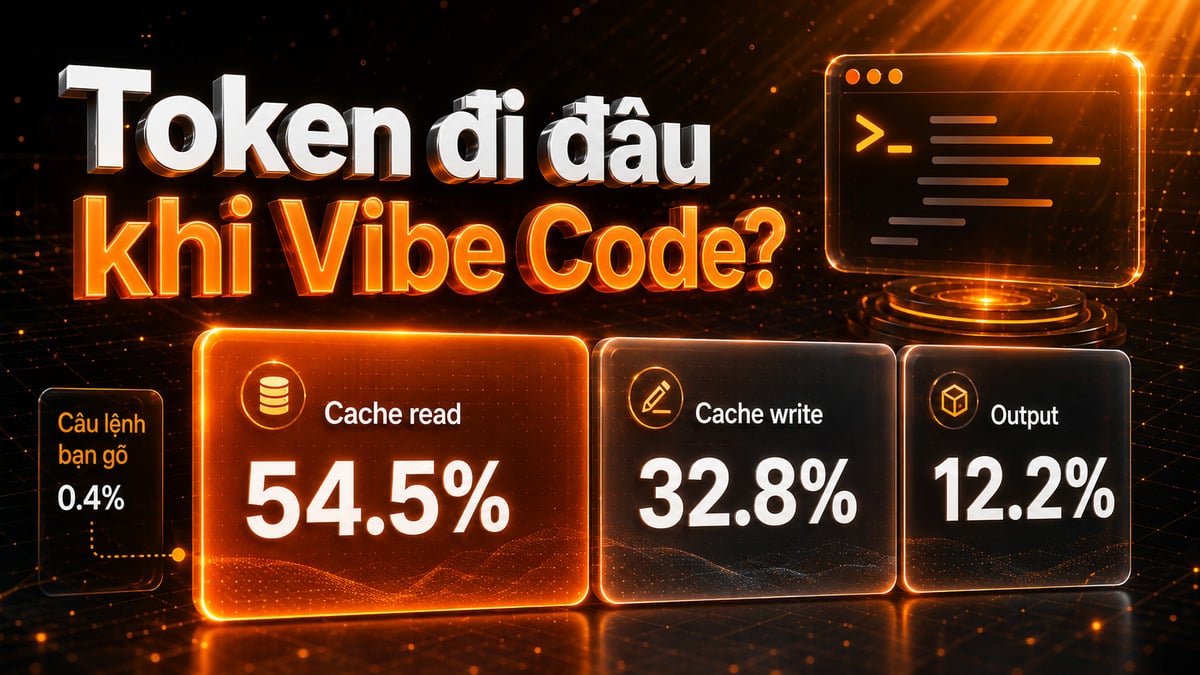
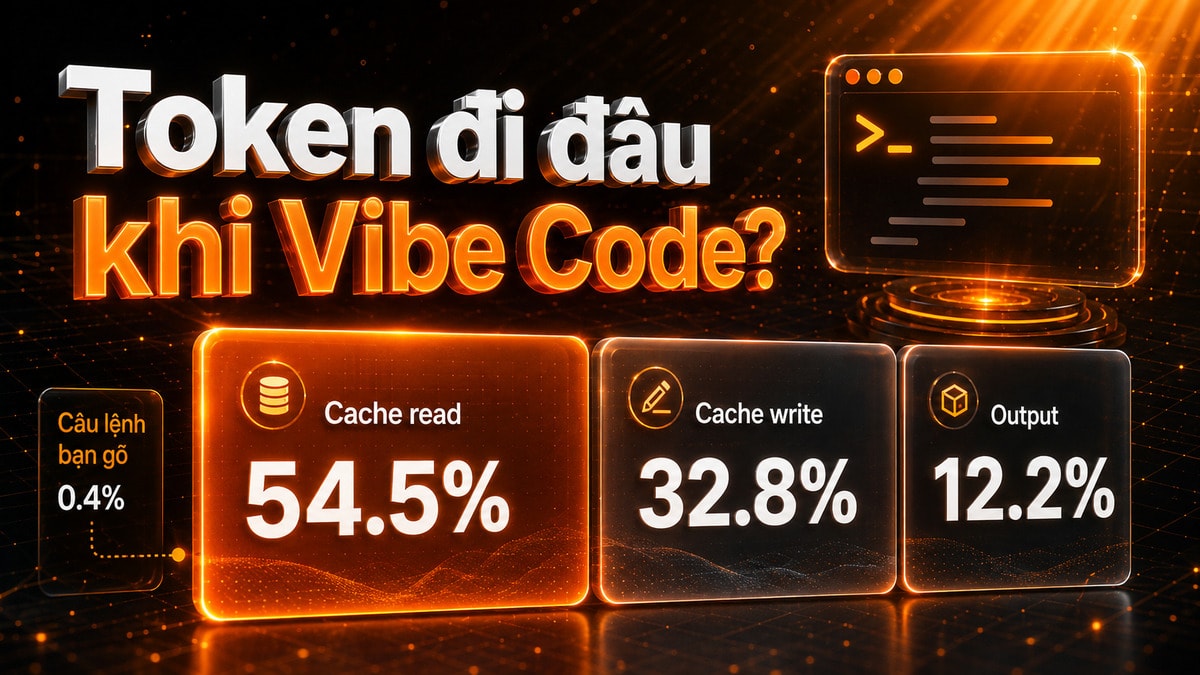
Đến khi tôi trích xuất dữ liệu thật từ quá trình làm website này, con số thực tế làm đảo lộn hoàn toàn cách nghĩ đó: tiền trả cho câu tôi gõ nhỏ đến mức gần như không đáng kể, trong khi khoản tiền quyết định hóa đơn lại nằm ở nơi khác hẳn.
Câu tôi gõ chỉ chiếm 0,5% hóa đơn
Trong bài về chi phí thật của vibe code, tôi từng chia sẻ một nguyên lý: mỗi khi gửi một câu hỏi ngắn, bạn không chỉ gửi riêng câu đó mà đang kéo theo toàn bộ lịch sử làm việc trước đó của cả phiên. Lúc đó tôi hiểu theo lý thuyết, nhưng chưa có số đo chi tiết để biết mức độ lệch pha lớn đến đâu.
Để có câu trả lời xác thực, tôi đã bóc toàn bộ 62 phiên Claude Code còn lưu trên máy của chính repository này, gồm 4.794 lượt gọi API, chốt số vào ngày 2026-09-02. Trong đó có 4.592 lượt chạy trên model Claude Opus 5, chiếm 95,8% tổng số lượt.
Quy đổi 4.592 lượt Opus 5 này theo biểu giá API, tổng chi phí quy đổi là 720,18 $. Cộng cả bốn model đã dùng trên repo thì con số là 755,26 $.
Một điểm cần nói rõ ngay từ đây, vì con số này còn quay lại nhiều lần trong bài: thực tế tôi dùng gói thuê bao trả phí hằng tháng chứ không trả theo hóa đơn API. Tôi lấy lượng token thật đã dùng rồi tính lại theo biểu giá API, vì biểu giá đó là thước đo duy nhất có đơn vị rõ ràng để bạn dễ hình dung. Mọi con số tiền trong bài đều là số quy đổi theo cách đó.
Con số bất ngờ nhất nằm ở dòng đầu tiên: toàn bộ phần input chưa cache — tức những câu lệnh mới, những chỉ dẫn mới và những đoạn văn bản do tôi tự gõ trong 62 phiên — chỉ tốn đúng 3,64 $.
3,64 $ trên tổng hóa đơn 755,26 $ tương đương 0,5%.
Điều đó có nghĩa nếu tôi dành cả ngày gọt giũa câu lệnh từ mười từ xuống năm từ, mức tiết kiệm tối đa chỉ là vài phần mười của một phần trăm. 99,5% chi phí còn lại của hệ thống không quan tâm bạn gõ dài hay ngắn. Tiền đang chảy qua những ngả đường hoàn toàn khác.
Ba loại token mà hóa đơn không tách ra cho bạn thấy
Bảng giá của các nhà cung cấp thường chỉ có hai cột: giá input và giá output mỗi triệu token. Cách trình bày phẳng này tạo cảm giác mọi token gửi lên đều có giá như nhau.
Thực tế khi chạy coding agent, token phía input chia thành ba loại rất khác biệt:
Thứ nhất là input chưa cache. Đây là nội dung mới trong lượt gọi hiện tại, chưa từng lưu ở các bước trước. Với Opus 5, loại này tính giá gốc là 5 $ mỗi triệu token.
Thứ hai là token ghi cache. Khi nạp một khối ngữ cảnh lớn và ổn định, hệ thống ghi khối này vào bộ nhớ tạm trên máy chủ.
Thứ ba là token đọc cache. Ở các lượt gọi tiếp theo trong cùng phiên, agent đọc lại ngữ cảnh đã lưu. Đây là loại token rẻ nhất — với Opus 5 chỉ tốn 0,5 $ mỗi triệu token, rẻ hơn mười lần so với input thường.
Tổng hợp 942,4 triệu token phía input qua 62 phiên, trên cả bốn model đã dùng, cơ cấu lộ diện rõ ràng:
Input chưa cache có 729.742 token, chiếm 0,08%. Ghi cache có 18.101.197 token, chiếm 1,92%. Đọc cache có 923.581.495 token, chiếm 98,00%. Ba tỉ lệ này tính trên 942,4 triệu token phía input; khi lấy mẫu số là tổng 946,8 triệu token kể cả token đầu ra thì ghi cache là 1,91% còn đọc cache là 97,55% — bảng gốc ở bài tổng hợp số liệu của chuỗi dùng mẫu số thứ hai, và đó cũng là mẫu số đi kèm mọi tỉ lệ hóa đơn trong bài này.
Tổng token output chỉ có 4.374.498 token. Tỉ lệ giữa token phía input và token output là 215,4 : 1. Tức để viết ra 1 token kết quả, agent phải duyệt qua trung bình hơn hai trăm token ngữ cảnh đầu vào.
Chỗ 98% token thật sự nằm
Tại sao tỉ lệ đọc cache lại chiếm tới 98%? Hơn 923 triệu token đó chứa những gì?
Mỗi lượt gọi của agent không chỉ nhận một câu prompt rời rạc. Để ra quyết định chính xác trên một dự án phần mềm thật, mỗi lượt gọi mang theo một gói ngữ cảnh gồm năm thành phần:
hướng dẫn cố định của dự án, lịch sử hội thoại từ đầu phiên, file đã đọc, mô tả các công cụ và kết quả công cụ trả về, rồi mới tới câu vừa gõ, và cuối cùng là câu trả lời.
Đây là lý do vì sao context chứ không phải prompt là nơi quyết định hành vi lẫn chi phí của agent. Càng làm việc lâu trong một phiên, khối ngữ cảnh nền càng dày, khiến mỗi câu hỏi tiếp theo đều phải gánh toàn bộ khối lượng dữ liệu khổng lồ của quá khứ.
Sự phân tán giữa 62 phiên phản ánh rất thật nhịp độ làm việc trên dự án:
Phiên nhỏ nhất chỉ có đúng 1 lượt, phiên lớn nhất 174 lượt, trung vị 82 lượt. Về quy mô dữ liệu, phiên nhỏ nhất tiêu thụ 104.665 token, phiên lớn nhất lên tới 48,1 triệu token, trung vị 15,0 triệu token mỗi phiên.
Tỉ lệ đọc cache theo từng phiên có trung vị 97,91% và cao nhất là 99,28%. Ngữ cảnh tích lũy chính là nơi tiêu thụ hầu hết tài nguyên của cỗ máy.
📥 Tải miễn phí
Bộ Khung Repo Cho AI Agent
Cache làm hóa đơn nhỏ đi 6,4 lần, và không làm gì khác
Nếu 98% dữ liệu gửi đi là đọc lại ngữ cảnh cũ, thứ cứu người dùng khỏi hóa đơn khổng lồ chính là cơ chế prompt caching.
Bảng phân bổ tiền của cả 4.794 lượt cho thấy vai trò của từng dòng:
Đọc cache tốn 462,01 $, chiếm 61,2% hóa đơn. Ghi cache bậc 1 giờ tốn 180,01 $, chiếm 23,8%. Output tốn 109,60 $, chiếm 14,5%. Input chưa cache tốn 3,64 $, chiếm 0,5%.
Tổng chi phí là 755,26 $, trung bình 0,1575 $ cho một lượt gọi.
Nếu không có cache và toàn bộ phần đọc lại đó bị tính theo giá input gốc, hóa đơn sẽ là khoảng 4.821 $.
Cơ chế prompt caching giúp hóa đơn nhỏ đi khoảng 6,4 lần.
Nhưng cần nhớ: cache không làm giảm lượng context được gửi đi mỗi lượt. Nó không làm agent đọc ít file hơn hay lịch sử ngắn lại. Nó chỉ làm phần được gửi lại rẻ hơn. Lượng dữ liệu luân chuyển vẫn nguyên vẹn, chỉ có đơn giá mỗi token đọc lại là giảm.
Bậc một giờ đắt gấp đôi bậc năm phút, và tôi dùng nó 100% số lần
Trong cơ chế của Anthropic, lưu trữ cache chia thành hai bậc thời gian sống:
Bậc 5 phút có giá ghi bằng 1,25 lần giá input thường. Bậc 1 giờ có giá ghi bằng 2 lần giá input thường.
Kiểm tra 18.101.197 token ghi cache trong bộ dữ liệu, toàn bộ 18,1 triệu token đều là bậc 1 giờ. Không có một token nào ở bậc 5 phút.
Nếu toàn bộ ghi ở bậc 5 phút với hệ số 1,25 lần, chi phí cho 4.592 lượt Opus 5 là 657,62 $ thay vì 720,18 $. Tức bậc 1 giờ đắt hơn 62,56 $.
Tại sao chấp nhận trả thêm 62,56 $ cho bậc 1 giờ?
Vì 5 phút là quá ngắn trong thực tế. Bạn dừng lại đọc tài liệu, kiểm tra giao diện đang chạy, hoặc suy nghĩ cấu trúc dữ liệu là bộ đệm 5 phút đã hết hạn. Khi cache trôi, lượt gọi sau phải ghi lại từ đầu với giá mới, biến nỗ lực tiết kiệm thành đắt đỏ hơn. Bậc 1 giờ cho bạn sự thong thả cần thiết giữa các lượt giao việc.
Cái giá của sự thong thả đó không nhỏ như vẻ ngoài. Ghi cache chỉ chiếm 1,91% tổng lượng token nhưng nuốt 23,8% hóa đơn — dòng chi phí lớn thứ hai, đứng trên cả tiền trả cho chữ mà model viết ra. Cơ chế khiến dòng này phình to và những thao tác âm thầm làm vỡ nó được mổ xẻ riêng trong bài luật cache token.
Chỗ tôi từng đếm sai, và cách phát hiện ra
Bản đầu tiên của bài này công bố những con số cao gần gấp đôi. Tôi để lại chuyện đó ở đây vì cái bẫy này nằm sẵn trong dữ liệu, ai tự đo cũng sẽ vấp.
Claude Code ghi mỗi phiên thành một file transcript. Trong file đó, một lần gọi API không được ghi thành một dòng. Nó được ghi thành nhiều dòng: một dòng cho khối suy nghĩ, rồi mỗi lần gọi công cụ thêm một dòng nữa. Và cả mấy dòng ấy đều mang y nguyên cùng một khối số liệu sử dụng.
Cộng theo dòng là đếm một hóa đơn ba lần.
Trên một phiên mẫu, 65 lần gọi API thật sinh ra 118 dòng. Có 43 lần gọi bị ghi thành nhiều dòng, và cả 43 đều lặp lại nguyên vẹn khối số liệu cũ. Áp lên toàn bộ repo, chênh lệch là 8.821 dòng so với 4.794 lần gọi thật, tức số lượt gọi phồng lên 1,84 lần và tổng token phồng lên 1,76 lần.
Cách sửa đơn giản: gom theo trường định danh của lần gọi trước khi cộng. Mỗi lần gọi tính đúng một lần. Mọi con số trong bài này đều đã đếm theo cách đó, và tôi khuyên bạn kiểm tra lại con số của mình bằng đúng phép thử này trước khi tin nó.
Ba công cụ trên cùng một repo, số thật của cả ba
Claude Code không làm một mình trên dự án này. Tôi chạy song song ba công cụ, mỗi cái một vai: Claude Code lập kế hoạch và soát lại, Codex xử lý những phần mã và tài liệu dựng bằng code, Antigravity chạy phần lớn khối lượng nghiên cứu và viết nháp tiếng Việt.
Bóc nhật ký của cả ba, đây là bức tranh đầy đủ:
Claude Code có 62 phiên, 4.794 lượt gọi, 946.786.932 token. Codex có 29 phiên, 3.188 lượt gọi, 437.691.606 token. Antigravity có 54 phiên và khoảng 5.874 lượt, nhưng lượng token thì tôi phải ước tính trong khoảng 806 triệu đến 1.152 triệu.
Tổng lại vào khoảng 2,36 tỉ token cho một website.
Chỗ khác nhau giữa ba con số đó không nằm ở khối lượng mà ở mức độ chắc chắn, nên tôi nói rõ luôn. Claude Code và Codex đều ghi thẳng số token của từng lượt gọi vào nhật ký trên máy, nên hai con số đầu là số đo. Antigravity lưu hội thoại dưới dạng cơ sở dữ liệu có nội dung mã hóa và không ghi một trường token nào, nên tôi chỉ đếm được số lượt rồi nhân với mức tiêu thụ trung bình mỗi lượt của hai công cụ kia. Đó là ước tính, và tôi để nguyên nó ở dạng một khoảng thay vì chọn đại một con số cho gọn bảng.
Một chi tiết đáng chú ý ở cột Codex: 95,77% token phía input của nó cũng là token được đọc từ cache, gần như trùng với tỉ lệ của Claude. Quy luật ngữ cảnh chiếm hết chi phí không phải đặc thù của một nhà cung cấp. Nó là hình dạng chung của mọi coding agent chạy vòng lặp đọc — sửa — kiểm tra trên một repo thật.
Dòng chi phí duy nhất tôi không đo được
Bên cạnh các con số rõ ràng về token input, ghi cache hay output, có một dòng chi phí luôn hiện diện nhưng tôi không bóc tách được: chi phí của những lần làm lại.
Khi giao việc phức tạp, agent có thể hiểu sai ý định, sửa nhầm file, hoặc sinh mã không vượt qua bài kiểm thử. Lúc đó bạn buộc phải can thiệp và yêu cầu làm lại.
Mỗi lần làm lại ngốn một lượt ngữ cảnh đầy đủ, mang theo toàn bộ token đọc cache và output mới. Khoản tiền đó có thật và nằm trọn trong 755,26 $ kia.
Tuy nhiên, transcript không gắn nhãn lượt nào là làm đúng ngay và lượt nào là sửa sai thất bại. Vì không có dữ liệu phân loại, tôi nói thẳng là tôi không biết chi phí làm lại chiếm bao nhiêu. Không đoán một con số không có căn cứ là câu trả lời đúng ở đây, để giữ trọn tính trung thực cho các số liệu còn lại.
Cách tự đo phiên của chính bạn
Bạn hoàn toàn có thể tự kiểm chứng trên máy của mình thay vì tin vào ước tính chung chung.
Toàn bộ số trong bài này không đến từ một công cụ đo nào cả. Claude Code ghi lại mọi phiên làm việc thành file transcript ngay trên máy bạn, và mỗi lượt gọi trong đó đã có sẵn bốn con số tôi cần: input chưa cache, ghi cache, đọc cache, output. Tôi chỉ gom theo định danh lần gọi rồi cộng chúng lại. Bạn làm được đúng như vậy với phiên của mình, và tôi khuyên cộng thử một phiên dài — chính tỉ lệ đọc cache của phiên đó sẽ nói cho bạn biết mình đang để phiên phình đến đâu.
Còn để ước tính trước khi bắt đầu, công cụ tính chi phí AI nhận thẳng bốn loại token đó theo từng vai trong workflow, cộng số lần gọi mỗi task, số retry kỳ vọng và tỉ lệ được chấp nhận — rồi trả về chi phí cho mỗi task được chấp nhận, không phải cho mỗi lần gọi.
Một lưu ý quan trọng: hạn mức của gói thuê bao không đo bằng token. Nhà cung cấp công bố cái đồng hồ — với Claude là reset mỗi năm tiếng, cộng một hạn mức tuần — nhưng không công bố hạn mức đó lớn bao nhiêu tính bằng token. Còn API thì tính thẳng theo token xử lý. Vì thiếu mẫu số, đừng quy đổi thuê bao sang token; mọi phép tính dựng trên một con số không ai công bố đều sai lệch về kinh tế.
Điều tôi nhận ra
Nhìn lại 62 phiên làm việc, bài học lớn nhất đọng lại nằm ở nhận thức về quy luật chi phí:
Muốn tiết kiệm tiền khi làm việc với coding agent, gọt giũa câu lệnh cho ngắn là việc ít hiệu quả nhất. Chỗ duy nhất đáng để bạn đầu tư công sức tối ưu hóa chính là cách quản lý ngữ cảnh: dọn dẹp các phiên làm việc đã quá dài, tổ chức tài liệu chỉ dẫn ngắn gọn và mạch lạc, chia nhỏ tác vụ lớn thành bước tập trung, và chỉ nạp file thật sự liên quan tới công việc hiện tại.
Trước khi khép lại, tôi muốn nói rõ về phạm vi của những con số trong bài:
Đây là số liệu thực tế của một người, trên một repo cụ thể, trong một khoảng thời gian nhất định — phản ánh thói quen làm việc của riêng tôi chứ không phải mẫu số chung cho tất cả mọi người. Nhật ký của Claude Code còn bị dọn tự động sau ba mươi ngày, nên phần trước đầu tháng 8 đã mất và không nằm trong bảng nào ở trên. Bài viết này nhằm mục đích cung cấp một số liệu thực tế để bạn tham khảo. Bạn hoàn toàn có thể tự kiểm tra con số thật của mình để điều chỉnh cho hợp lý.
Thứ đáng tối ưu vì vậy không phải câu bạn gõ, mà là kích thước cái túi ngữ cảnh mà câu đó kéo theo: giữ cửa sổ phiên gọn, giữ file dặn dò gọn, và đừng để agent tự nạp thứ nó không cần đọc. Ba việc đó nằm ở tầng đầu tiên trong ba tầng quyết định của cả chuỗi.
Nếu muốn tự bóc tách 4 luồng token và ghi chép chi phí sau mỗi phiên làm việc, bạn có thể xem file bảng tính và hướng dẫn đo đạc trong bộ Token Efficient Vibe Coding Kit.