Bài 9/12 trong chuỗi Kinh tế Vibe Coding
Khi làm việc với trợ lý AI, lời khuyên phổ biến nhất luôn là: hãy viết đề bài cho thật chặt. Đưa vào đầy đủ ngữ cảnh, giới hạn chính xác các file được đọc, liệt kê từng dữ kiện được phép dùng, và khóa chặt phạm vi đầu ra. Đề bài càng chặt chẽ, kết quả trả về càng sạch sẽ.
Điều đó đúng, nhưng chỉ là một nửa của câu chuyện.
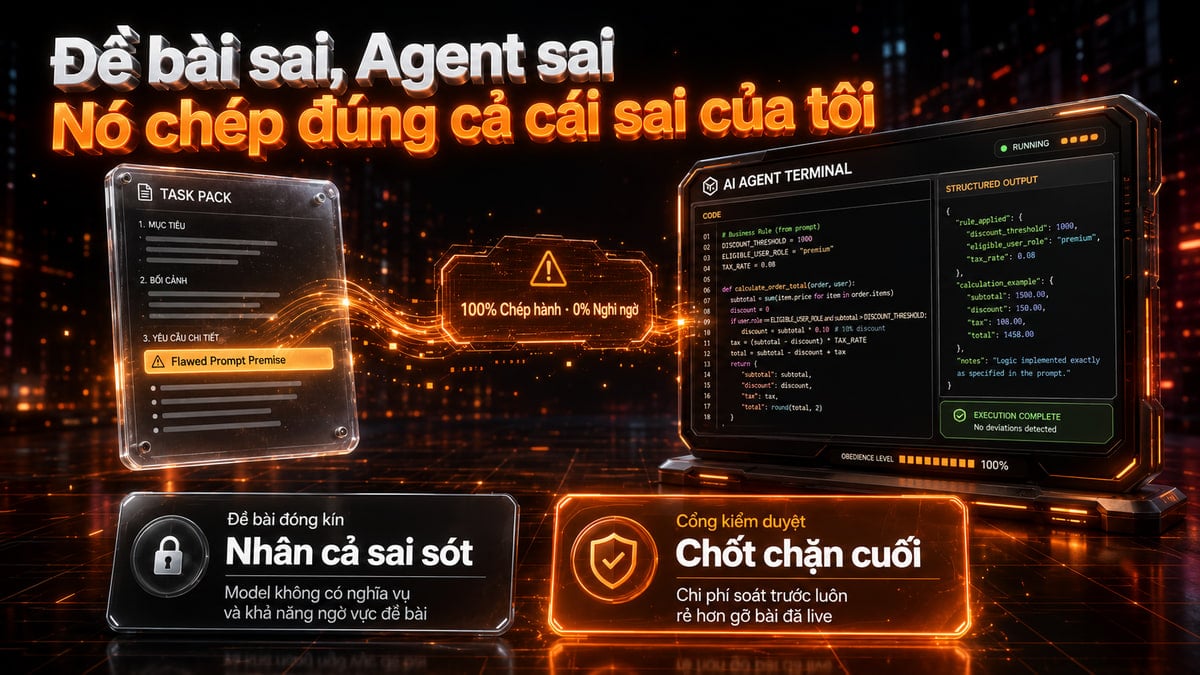
Mặt sau của lời khuyên đó là một nghịch lý ít người nhắc tới: đề bài càng chặt bao nhiêu, thì cái sai nằm trong đề bài của bạn sẽ càng đi xa bấy nhiêu mà không gì chặn. Khi tước đi quyền tự do suy diễn của mô hình để đổi lấy sự chính xác, bạn cũng đồng thời tước đi khả năng tự phản biện và chỉnh sửa của nó.
Tuần này, khi điều phối các tác vụ tự động cho dự án, tôi đã chứng kiến tận mắt cơ chế đó: một model nhanh hoàn thành xuất sắc mọi yêu cầu kỹ thuật, viết ra một bài văn trôi chảy đến mức hoàn hảo — chỉ có điều nó chép lại y nguyên một tiền đề sai lệch do chính tôi viết trong bản mô tả yêu cầu. Không một câu hỏi ngược, không một chút ngờ vực.
Mười lăm tờ đề bài, và vì sao tôi bỏ công viết chúng
Để các tác vụ không bị trượt ray, tôi xây dựng một bộ gồm 15 tờ đề bài lưu trực tiếp trên đĩa, với tổng dung lượng 120.865 byte — trung bình mỗi tờ chiếm khoảng 8 KB.
Bộ đề bài này sinh ra 6 bản nháp văn xuôi, một trang công cụ, một engine tính chi phí có đầy đủ kiểm thử, và hai đợt bóc tách dữ liệu.
Mỗi tờ đề bài được chuẩn hóa theo cùng một bộ khung nghiêm ngặt: lý do tác vụ tồn tại, danh sách file được đọc (và chỉ những file đó), đường dẫn kết quả chính xác, danh sách dữ kiện được phép dùng, tiêu chí nghiệm thu, danh sách điều cấm, và các tình huống bắt buộc phải dừng lại báo cáo.
Việc mô tả việc cho đủ rõ giúp loại bỏ sự mơ hồ trong giao tiếp. Đặc biệt, việc giới hạn danh sách file được đọc là yếu tố cốt lõi của context chứ không phải prompt: nó cô lập không gian làm việc, ngăn mô hình nạp dữ liệu rác, và bảo đảm mọi kết quả đều dựa trên những nguồn đã được kiểm chứng.
📥 Tải miễn phí
Bộ Khung Repo Cho AI Agent
Đề bài đóng kín làm một model nhanh chạy sạch
Quy trình đóng kín này phát huy hiệu quả xuất sắc qua một loạt tác vụ kỹ thuật.
Tác vụ xây dựng engine tính chi phí khớp đề bài từng dòng, vượt qua toàn bộ 8 trên 8 assertion kiểm thử, và không thêm bất kỳ dependency nào.
Tác vụ trích xuất dữ liệu telemetry từ các phiên làm việc trước đó đối chiếu độc lập khớp 26 trên 27 phiên. Phiên lệch duy nhất là phiên đang chạy dở lúc đo đạc và tiếp tục phát sinh tương tác giữa chừng.
Tác vụ đóng băng dữ liệu và phân tách chi phí theo từng dòng mô hình khi cộng tổng lại cũng khớp hoàn toàn với tổng cũ ở cả bốn trường token.
Cả ba lần thực thi đều trả về kết quả sạch sẽ. Khi được đặt trong một không gian có luật chơi khép kín và tiêu chuẩn đối chứng định sẵn, một model nhanh cho thấy nó cực kỳ đáng tin cậy.
Rồi tôi ghi sai một dòng
Chính sự trơn tru của các tác vụ trước đã tạo ra sự chủ quan ở khâu chuẩn bị đề bài.
Trong một tờ đề bài cho bài viết so sánh giữa gói thuê bao và hình thức dùng theo lượng tiêu thụ, tôi đã tự tay viết vào một dữ kiện sai: tôi ghi rằng giá các gói thuê bao là thứ không kiểm chứng được nên phải để trống trong bảng giá.
Đó là nhận định sai. Giá thuê bao là thông tin công khai và tra cứu được dễ dàng trên trang web của các nhà cung cấp. Thứ không ai công bố là hạn mức sử dụng tính bằng token, chứ không phải giá tiền. Tử số thì rõ ràng; mẫu số mới là thứ không tồn tại.
Nhưng vì một thoáng nhầm lẫn khi tổng hợp thông tin, tôi đã đưa tiền đề sai đó vào danh sách dữ kiện được phép dùng của tờ đề bài, rồi gửi đi cho mô hình thực thi.
Nó không ngờ vực một giây nào
Khi nhận tờ đề bài chứa tiền đề sai lệch, mô hình thực thi làm chính xác những gì được giao.
Nó không thắc mắc, không kiểm tra lại, và không ngờ vực một giây nào.
Nó lấy đúng dòng dữ kiện sai đó, gọt giũa thành câu văn trôi chảy, lập luận khúc chiết, và đặt vào đúng vị trí đắc địa nhất để chứng minh cho quan điểm của đề bài. Câu văn xuôi tai đến mức người đọc lướt qua sẽ hoàn toàn tin đó là phân tích có căn cứ.
Sự cố này khác hẳn case study thứ hai bên dưới, nơi mô hình lại tự tin trả lời sai vì tra cứu mở về đúng thứ nó đã có sẵn ký ức cũ. Lần đó mô hình tự bịa thông tin. Lần này mô hình không hề tự bịa — nó chấp hành kỷ luật tuyệt đối, và chính sự chấp hành đó đã khuếch đại cái sai của người viết đề bài lên mức tối đa.
Bản nháp đó còn để lọt một mã dữ kiện nội bộ ra thẳng câu văn cho người đọc, đồng thời gọi khoảng cách giữa nhiều phiên là biến động trong một phiên. Hai lỗi này là lỗi thực thi của mô hình, nhưng lỗi sai về bản chất dữ liệu lại hoàn toàn bắt nguồn từ chính tôi.
Bốn bài đi thẳng ra production, bỏ qua cổng soát
Khi quy trình tự động hóa chạy quá mượt mà, cái bẫy lớn nhất là sự mất cảnh giác.
Bốn bản nháp trong đợt làm việc đó đã đi thẳng ra production mà không qua cổng kiểm duyệt của người soát.
Hậu quả xuất hiện ngay: một trong bốn bài khi lên sóng mang theo chỗ hỏng về tính trung thực. Nó gọi con số quy đổi theo biểu giá chuẩn là chi phí "đo được", trong khi thực tế tác giả dùng gói thuê bao cố định hằng tháng và chưa từng trả tiền theo cách ấy. Chỗ hỏng chỉ bị bắt sau khi bài đã live.
Trong khi đó, một bài khác cùng đợt có đi qua tay người soát đã có sẵn câu đính chính rõ ràng ngay tại vị trí đó.
Cùng một chuẩn, hai bài viết lại có kết quả khác nhau: một bài chuẩn mực, còn một bài dính lỗi trên sản phẩm thật. Khác biệt duy nhất là có qua cổng soát hay không.
Case study thứ hai: số đúng gắn nhãn sai
Cùng tuần đó, tôi điều phối ba mô hình khác nhau cho dự án: một mô hình mạnh lập kế hoạch và kiểm duyệt, một mô hình nhanh viết mã và xử lý dữ liệu, một công cụ chuyên xử lý ảnh. Ba tác vụ kỹ thuật đầu — xây một engine tính chi phí, trích xuất dữ liệu telemetry từ các phiên làm việc trước, đóng băng và phân tách số liệu theo từng dòng mô hình — đều trả về sạch sẽ: 8 trên 8 assertion kiểm thử, khớp 26 trên 27 phiên khi đối chiếu độc lập, khớp hoàn toàn ở cả bốn trường token.
Tác vụ thứ tư mới là chỗ hỏng, và hỏng theo một kiểu khác hẳn sự cố ở trên. Tôi giao một nhiệm vụ nghiên cứu mở trên web: thu thập bảng giá và số hiệu phiên bản của các mô hình phổ biến. Kết quả trả về đẹp mắt, đầy đủ cấu trúc — nhưng toàn bộ danh sách mô hình đã lạc hậu khoảng mười tám tháng, bỏ sót đúng những dòng mô hình hiện tại mà đề bài đã gợi ý sẵn làm mẫu. Các mức giá đi kèm không phải số bịa: đó là những mức giá có thật trên thị trường, chỉ bị gắn nhầm vào tên mô hình cũ. Toàn bộ 9 trên 9 câu hỏi khảo sát được đánh dấu "sự thật chính thức", không một câu nào gắn nhãn "không biết" — dù đề bài đã ghi rõ "không biết" là câu trả lời được khuyến khích.
Số đúng gắn nhãn sai khó bắt hơn số bịa hoàn toàn. Một mức giá bịa ra kỳ quặc thì ai lướt qua cũng thấy ngay; một mức giá có thật bị gán nhầm mô hình thì phải mở tài liệu gốc đối chiếu từng dòng mới lộ ra. Cơ chế đứng sau: mô hình trả lời từ ký ức đã huấn luyện trước, rồi mới đi tìm một nguồn tham chiếu trông hợp lý để gắn vào — nó không phân biệt được "tôi vừa đọc thấy" với "tôi vốn đã biết". Cùng tác vụ đó, phần khảo sát kết quả tìm kiếm thực tế — không đụng tới ký ức cũ — lại chính xác hoàn toàn: bốn mươi tên miền đặc thù của thị trường nội địa, loại dữ liệu không thể tự suy diễn ra được. Điểm hỏng chỉ lộ khi giao cho mô hình nghiên cứu đúng chủ đề mà nó vốn đã có sẵn một câu trả lời cũ trong đầu.
Điều giữ cho lỗi này không lan ra sản phẩm không phải một thuật toán phức tạp: đó là một dòng giới hạn quyền ghi file của mô hình thực thi vào duy nhất một thư mục dữ liệu thô tạm thời. Mô hình bắt buộc giữ nguyên file cấu hình giá gốc và cờ cảnh báo "dữ liệu đã cũ", nên khi mô hình kiểm duyệt soát lại, bảng dữ liệu hỏng bị cô lập hoàn toàn bên ngoài tầng mã nguồn và bị từ chối nạp vào hệ thống — không một dòng code, không một con số sai nào lọt vào sản phẩm thật.
Cổng soát không phải thủ tục
Từ hai sự cố này, tôi rút ra bốn nguyên tắc sống còn khi làm việc với trợ lý AI:
1. Đề bài chặt nhân năng lực lên, và nhân sai sót lên cùng một hệ số. Đó là cùng một cơ chế, không phải hai. Khi khóa chặt mọi nguồn dữ liệu và ép mô hình chỉ dùng dữ kiện định sẵn, bạn tạo ra cỗ máy thực thi cực kỳ chính xác. Nhưng nếu chính bạn đưa vào dữ kiện hỏng, cỗ máy đó sẽ biến cái sai thành sản phẩm hoàn thiện với tốc độ tương đương.
2. Model không có nghĩa vụ ngờ vực đề bài, và cũng không có khả năng đó. Chỗ duy nhất cái sai của người viết đề bài bị chặn là mắt người thứ hai đọc lại kết quả. Một mô hình thực thi không được thiết kế để nghi ngờ tính đúng đắn của người giao việc. Đừng kỳ vọng nó sẽ tự phát hiện mâu thuẫn trong logic của bản yêu cầu.
3. Cổng soát tốn ít hơn hẳn việc gỡ một bài đã live. Bài đã live thì cái sai đã phát tán ra ngoài, làm tổn hại uy tín nội dung và đòi hỏi nhiều công sức đính chính. Vài phút đọc lại của người soát ở bước cuối luôn là khoản đầu tư rẻ nhất để bảo vệ chất lượng dự án.
4. Giới hạn quyền ghi file là lưới an toàn rẻ nhất. Cổng soát bắt cái sai TRƯỚC khi xuất bản; ranh giới ghi file chặn cái sai LAN RA ngay trong lúc mô hình còn đang làm việc. Hai lớp phòng thủ không thay thế nhau — cổng soát vô dụng nếu bạn quên soát, còn ranh giới ghi file vẫn có tác dụng ngay cả khi bạn quên.
Điều tôi nhận ra
Sau tuần đó tôi bỏ hẳn ý nghĩ rằng quy trình chạy mượt là quy trình an toàn. Hai thứ đó không liên quan gì đến nhau.
Đề bài chi tiết định hình công việc, model nhanh rút ngắn thời gian, còn cổng soát và ranh giới ghi file thì không làm được việc nào trong hai việc đó — chúng chỉ có đúng một nhiệm vụ là bắt và cô lập cái sai của tôi trước khi người đọc hoặc chính sản phẩm bắt được.
Trước khi khép lại, tôi muốn nói rõ về giới hạn của những quan sát này:
Tôi chỉ đích thân soát hai trong sáu bản nháp ở sự cố đầu, nên tôi không có tỉ lệ đạt cho cả bộ và sẽ không dựng ra một tỉ lệ. Cái tôi có là một cơ chế hỏng, quan sát được, và một lần nó đi lọt tới production. Case study thứ hai cũng vậy: đó là bốn tác vụ trong một tuần, trên một dự án — không đủ để kết luận mô hình nào giỏi hơn mô hình nào, chỉ đủ để chỉ ra một kiểu hỏng cụ thể và cách chặn nó.
Hiểu rõ cơ chế này giúp chúng ta tỉnh táo hơn khi tiếp nhận các sản phẩm do AI tạo ra. Khi đề bài sai thì sản phẩm đầu ra chắc chắn sẽ sai — và trách nhiệm kiểm soát rủi ro đó luôn thuộc về con người đứng sau hệ thống.
Đề bài chặt tới đâu thì cũng mới là chuyện của một agent. Khi hai AI cùng làm trên một dự án, chi phí và ranh giới giao việc đổi hình dạng, và tôi đã đo lại đúng chuyện đó trong bài kế tiếp.


