Bài 10/12 trong chuỗi Kinh tế Vibe Coding
Khi thiết kế một quy trình phối hợp giữa hai AI — dùng một mô hình đắt giá để lập kế hoạch rồi chuyển cho một mô hình dồi dào chạy việc — kỳ vọng phổ biến nhất là cắt giảm được 80% đến 90% chi phí. Nhưng khi tôi mở toàn bộ file transcript của năm phiên làm việc thật trên một dự án thực tế, bóc từng lượt gọi API và đo đến từng đồng đô-la, con số ghi lại cho thấy một bức tranh hoàn toàn khác: 72,6% số tiền trong hoá đơn không trả cho bất kỳ dòng code hay dòng chữ nào được viết ra. Nó trả cho việc mô hình phải đọc đi đọc lại những gì đã diễn ra trước đó trong phiên.
Phần lớn chúng ta khi bàn về nguyên tắc phân luồng công việc giữa các agent đều hình dung bài toán theo kiểu: chia việc cho mô hình rẻ làm thì hoá đơn sẽ teo lại tương ứng với khối lượng code giao đi. Nhưng thực tế vận hành có những quy luật cơ học riêng, và nếu đo nhầm thước, bạn vừa tốn thêm công viết đề bài vừa không tiết kiệm được bao nhiêu hạn mức.
1. Con số từ năm phiên chạy thật: tiền không đi vào chỗ bạn nghĩ
Dự án được đem ra đo lường là một công cụ nội bộ cho khách hàng tên Chris: gom 205 hồ sơ nhà máy dạng PDF thành cơ sở dữ liệu tìm kiếm được, kèm một bảng theo dõi dự án thay cho Notion. Hệ thống viết bằng Next.js và chạy thử nghiệm qua Cloudflare Tunnel. Trong hai ngày 27 và 28 tháng 8 năm 2026, có năm phiên Claude Code được ghi nhận trọn vẹn, xen kẽ với các đợt giao việc cho Gemini thực thi.
Nguồn dữ liệu không phải là bảng ước lượng hay trí nhớ sau phiên, mà là file transcript .jsonl do Claude Code tự động ghi lại. Mỗi phản hồi của mô hình đều mang một khối usage với bốn thông số: input, output, cache write và cache read. Mọi phản hồi đều được khử trùng lặp theo message.id trước khi cộng — cùng vai trò với trường requestId mà công cụ đo về sau của tôi dùng, cả hai đều định danh đúng một lượt gọi API để nó chỉ được đếm một lần — nếu không khử, mọi con số sẽ phồng lên gần gấp đôi do cơ chế lưu nhật ký phân đoạn.
Đơn giá quy đổi được tính theo bảng giá niêm yết công khai của Claude Opus 5: 5 đô la cho input, 25 đô la cho output, 6,25 đô la cho cache write và 0,50 đô la cho cache read trên mỗi triệu token.
| Phiên | Thời gian | Vai trò | Lượt gọi | Token chữ | Token tính tiền | Chi phí | $/1k chữ |
|---|---|---|---|---|---|---|---|
93dcca17 | 27/08 09:52–10:50 | Khảo sát dữ liệu, dựng P0, viết kế hoạch giao Gemini | 110 | 141.886 | 24,0M | $17,07 | 0,120 |
b2cbe0ed | 27/08 14:49–17:28 | Lập kế hoạch thuần — 3 pack cho Gemini, không sửa code | 64 | 100.406 | 11,1M | $10,14 | 0,101 |
dd053729 | 27/08 22:18–23:15 | Nghiệm thu bài Gemini, tự vá lỗ hổng, viết pack WO-4 | 143 | 105.511 | 24,5M | $16,11 | 0,153 |
32173a05 | 28/08 15:55–16:53 | Claude tự triển khai WO-5 đợt A + B | 135 | 164.605 | 35,0M | $23,26 | 0,141 |
66abad03 | 28/08 18:27–21:28 | Claude tự triển khai WO-6, phản hồi vòng 3 của Chris | 216 | 123.975 | 51,5M | $32,41 | 0,261 |
| Tổng cộng | 2 ngày | 5 phiên làm việc thực tế | 668 | 636.383 | 146,1M | $99,00 | 0,156 |
Cùng một lượng chữ và code tạo ra, phiên đắt nhất tốn gấp 2,6 lần phiên rẻ nhất tính trên mỗi nghìn token output: từ 0,101 đô la ở phiên lập kế hoạch thuần lên tới 0,261 đô la ở phiên thực thi phức tạp.
Lưu ý thực tế: Trong quá trình làm dự án, tôi dùng gói thuê bao trả phí hằng tháng chứ không trả theo hóa đơn API như bảng tính trên. Tuy nhiên, vì nhà cung cấp công bố cửa sổ reset của gói thuê bao mà không công bố hạn mức đó lớn bao nhiêu tính bằng token, rất khó so sánh định lượng, tôi dùng bảng giá API làm thước đo chuẩn để bạn dễ hình dung sự chênh lệch chi phí giữa các mô hình.
2. 72,6% hoá đơn là tiền đọc lại chính mình
Khi bóc tách cơ cấu chi phí gộp của toàn bộ 99,00 đô la trên cả năm phiên, cơ cấu phân bổ dòng tiền đã làm sáng tỏ mọi ngộ nhận:
- Cache read (đọc lại lịch sử hội thoại đã có): 71,84 đô la — chiếm 72,6% tổng chi phí.
- Output (chữ và code mô hình viết ra): 15,91 đô la — chiếm 16,1%.
- Cache write (ghi vào bộ nhớ đệm): 10,65 đô la — chiếm 10,8%.
- Input (dữ liệu đầu vào mới): 0,59 đô la — chiếm 0,6%.
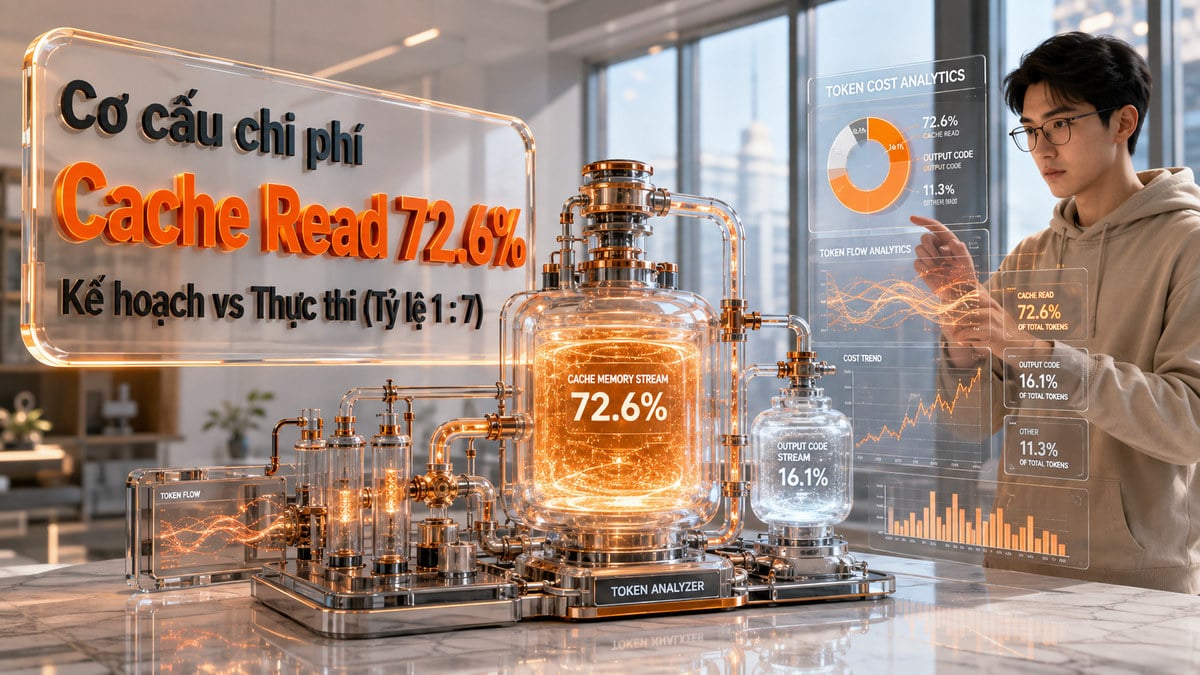
Con số này mang lại một kết luận then chốt: chi phí không hề tỷ lệ thuận với lượng code bạn sản xuất được. Nó tỷ lệ với số lượt gọi nhân với kích thước context tại lượt đó.
Có một chỗ trong bảng trên tôi phải nói rõ, vì sau này đo lại tôi mới thấy nó quan trọng. Cache write ở đây được quy đổi theo hệ số 1,25 lần giá input, tức bậc lưu trữ 5 phút. Nhưng khi bóc toàn bộ 4.794 lượt gọi trên chính repo nguyenxuantai.com, tôi thấy 100% token ghi cache đều rơi vào bậc 1 giờ, mà bậc 1 giờ tính bằng 2 lần giá input chứ không phải 1,25 lần. Nếu năm phiên của dự án Chris cũng ghi ở bậc 1 giờ — nhiều khả năng là vậy vì cùng một công cụ và cùng một cấu hình — thì dòng cache write trong bảng phải nhân lên 1,6 lần, và tỷ trọng của nó trong hoá đơn tăng từ 10,8% lên khoảng 16%.
Tôi không sửa thẳng con số trong bảng, vì transcript của dự án đó không còn trên máy để tôi kiểm lại bậc lưu trữ. Nhưng trên bộ dữ liệu tôi kiểm được đầy đủ, cơ cấu chi phí là: đọc cache 61,2%, ghi cache 23,8%, output 14,5%, input chưa cache 0,5%. Ghi cache chỉ chiếm 1,92% lượng token nhưng nuốt gần một phần tư hoá đơn. Nếu bạn tự đo phiên của mình, hãy nhìn xem token ghi cache của bạn nằm ở bậc nào trước khi nhân giá — đó là chỗ dễ tính hụt nhất, và là đúng cơ chế tôi mổ xẻ riêng trong bài về luật cache.
Mỗi lệnh bash chạy kiểm tra, mỗi lần đọc một đoạn file, mỗi lần chỉnh sửa một dòng mã nguồn đều được tính là một lượt gọi API riêng biệt. Và ở mỗi lượt gọi đó, mô hình bắt buộc phải chở theo toàn bộ những gì đã tích luỹ từ đầu phiên đến giờ.
Trong mọi phiên làm việc, kích thước context luôn tăng một chiều: bắt đầu ở khoảng 83k token và kết thúc ở mức 250k đến 360k token. Một lượt gọi ở cuối phiên đắt gấp bốn lần chính lượt gọi đó ở đầu phiên, dù công việc thực hiện bên trong không hề khác biệt.
Hệ quả trực tiếp là: cắt bớt một lượt gọi không chỉ tiết kiệm chi phí của riêng thao tác đó, mà còn làm nhẹ context cho tất cả những gì diễn ra phía sau nó. Sự tiết kiệm trong môi trường agent là tiết kiệm cộng dồn, hoàn toàn không phải tuyến tính.
Để áp dụng ngay mô hình này vào dự án của riêng bạn mà không phải tự viết lại các quy tắc từ đầu, tôi đã đóng gói bộ khung bàn giao hai AI gồm hai file cấu hình mẫu: CLAUDE.md (bộ chỉ thị toàn cục thiết lập Verifiability Gate, giới hạn quyền hạn và quy tắc giao việc cho Claude) và README.md (hồ sơ dự án chứa danh sách lệnh nghiệm thu tự động). Bạn chỉ cần tải về, giải nén và thả trực tiếp vào thư mục gốc của dự án để agent tự động tuân thủ kỷ luật phân luồng và nghiệm thu trước khi bàn giao.
3. Bản giao việc tốn bao nhiêu: một bài toán 1 trên 7
Khi gộp tất cả các giai đoạn cùng loại trên cả năm phiên làm việc, tỷ lệ chi phí thực tế giữa các phần việc được phân định rõ ràng:
- Thực thi: 55,37 đô la — chiếm 56%.
- Kế hoạch & nghiệm thu: 39,06 đô la — chiếm 39%.
- Bàn giao: 4,57 đô la — chiếm 5%.
Tỷ lệ này bác bỏ trực giác quen thuộc rằng lập kế hoạch là phần rẻ còn viết code là phần đắt. Trong dữ liệu đo được, kế hoạch và nghiệm thu chiếm gần bốn phần mười tổng chi phí. Vì vậy, việc giao toàn bộ phần viết code cho Gemini thực thi không thể làm hoá đơn Claude giảm 90% — trần lý thuyết của việc cắt giảm chỉ là 56%, và thực tế thấp hơn nhiều vì phần nghiệm thu sẽ phình to ra.
Vậy viết một hồ sơ giao việc task pack tốn bao nhiêu tiền?
Ở phiên b2cbe0ed (phiên thuần lập kế hoạch, không sửa một dòng code nào) và phiên dd053729, bốn bản pack cho Gemini được đo đạc chính xác:
| Bản giao việc | Số dòng | Số lượt gọi | Token chữ | Context TB | Chi phí ($) |
|---|---|---|---|---|---|
WORK_ORDER_SEARCH_NOTES | 381 dòng | 20 lượt | 34.249 | 117k | $2,52 |
WORK_ORDER_2_PRECISION | ~430 dòng | 20 lượt | 25.376 | 170k | $2,57 |
WORK_ORDER_3_USABILITY | 367 dòng | 24 lượt | 40.781 | 218k | $5,06 |
WO-4 | ~120 dòng | 7 lượt | 14.636 | 271k | $1,46 |
| Tổng cộng 4 pack | ~1.180 dòng | 64 lượt | 100.406 | — | $10,14 |
Trung bình, một bản giao việc khoảng 400 dòng tốn khoảng 3 đô la và từ 20 đến 24 lượt gọi. Hãy để ý: bản giao việc thứ ba đắt gấp đôi bản đầu tiên chỉ vì nó được viết ở context 218k thay vì 117k — dù khối lượng công việc là tương đương nhau.
So với chi phí Claude tự thực thi trọn vẹn một đợt việc lớn (21,82 đô la ở phiên 32173a05 và 25,47 đô la ở phiên 66abad03), tỷ lệ giữa chi phí viết kế hoạch và chi phí tự thực thi rơi vào khoảng 1 : 7.
4. Nghiệm thu thực tế: Gemini làm đúng gì và bỏ sót những gì
Trích từ biên bản nghiệm thu được Claude viết lúc 22:34 ngày 27 tháng 8 năm 2026, sau khi chạy lại toàn bộ bộ kiểm thử trên máy chủ thật:
Gemini làm đúng phần lớn khối lượng công việc. Claude kiểm chứng từng mục tiêu và xác nhận: toàn bộ bài test cấp quyền chạy thành công với mã trả về exit 0; cả 9 đường dẫn ẩn danh đều trả về mã 307 hoặc 401 không rò rỉ dữ liệu; header X-Robots-Tag: noindex xuất hiện đầy đủ trên cả 9 phản hồi kể cả file PDF; trích dẫn dẫn đúng tài liệu gốc khi tải PDF về đọc trang 27 văn bản khớp từng chữ; ghi chú lưu trữ sống sót qua lần khởi động lại máy chủ thật; và lệnh next build vượt qua hoàn toàn.
Nhưng có ba lỗi Gemini không thể tự phát hiện, và hai trong số đó là những lỗ hổng bảo mật nghiêm trọng:
Thứ nhất, cookie phiên làm việc chứa mật khẩu ở dạng đọc được nguyên văn. Giá trị cookie được gán bằng base64("aup:aup2026:aup_trial_secret_2026") — chỉ cần giải mã base64 là thấy ngay mật khẩu gốc. Bất kỳ dòng nhật ký log, proxy trung gian hay ảnh chụp màn hình nào vô tình để lộ cookie là lộ luôn khoá truy cập hệ thống.
Thứ hai, mật khẩu mặc định bị hardcode trực tiếp trong mã nguồn. Dòng mã process.env.APP_PASSWORD || 'aup2026' nằm ở cả middleware lẫn route xác thực, và chuỗi aup2026 thậm chí còn được viết thẳng vào file tài liệu hướng dẫn dùng thử chuẩn bị commit lên kho mã nguồn. Nếu đưa lên môi trường thật mà quên đặt biến môi trường, hệ thống sẽ mở toang cánh cửa với mật khẩu mà bất kỳ ai đọc repo cũng biết.
Lỗi thứ ba tinh vi hơn: hai bài test đăng nhập báo thành công nhưng ngay request sau đó lại nhận mã 401. Claude truy vết và phát hiện đây là lỗi của chính bộ kiểm thử chứ không phải lỗi của ứng dụng — thư viện http.cookiejar từ chối gửi cookie có cờ Secure qua giao thức HTTP, trong khi trình duyệt thật coi localhost là môi trường an toàn nên vẫn gửi bình thường. Việc phân biệt được "ứng dụng sai" hay "bài test sai" là loại phán đoán ngữ cảnh mà không một lệnh chạy tự động nào có thể tự kết luận được.
Đây chính là lý lẽ mạnh mẽ nhất cho mô hình phối hợp giữa hai AI: Gemini hoàn thành khối lượng cơ bắp khổng lồ và phần lớn chạy đúng. Nhưng những chỗ nó bỏ sót lại là những thứ mà tiêu chí hoàn thành không thể kiểm tra bằng cách chạy thử một lệnh đơn thuần — cookie giải mã ra mật khẩu vẫn vượt qua mọi bài kiểm thử, bởi bài test chỉ kiểm tra xem người dùng có đăng nhập được hay không.
Ranh giới phân việc vì thế không nằm ở độ khó hay độ dài dòng code, mà nằm ở chỗ: tiêu chí xong có kiểm chứng được bằng một lệnh chạy hay không. Kiểm chứng được bằng lệnh thì giao đi. Cần phán đoán và tư duy kiến trúc thì giữ lại.
Để áp dụng ngay mô hình này vào dự án của riêng bạn mà không phải tự viết lại các quy tắc từ đầu, tôi đã đóng gói bộ khung bàn giao hai AI gồm hai file cấu hình mẫu: CLAUDE.md (bộ chỉ thị toàn cục thiết lập Verifiability Gate, giới hạn quyền hạn và quy tắc giao việc cho Claude) và README.md (hồ sơ dự án chứa danh sách lệnh nghiệm thu tự động). Bạn chỉ cần tải về, giải nén và thả trực tiếp vào thư mục gốc của dự án để agent tự động tuân thủ kỷ luật phân luồng và nghiệm thu trước khi bàn giao.
Để hiểu sâu hơn về cách cấu trúc file chỉ thị CLAUDE.md chuẩn và nguyên lý hoạt động của system prompt khi làm việc với coding agent, bạn có thể tham khảo thêm bài viết System Prompt là gì và vì sao bạn nên dùng khi làm việc với AI Agent?.
5. Ba nghịch lý đi ngược trực giác khi phối hợp hai AI
Từ các số liệu đo lường thực tế, có ba phát hiện đi ngược lại hoàn toàn những phán đoán thông thường:
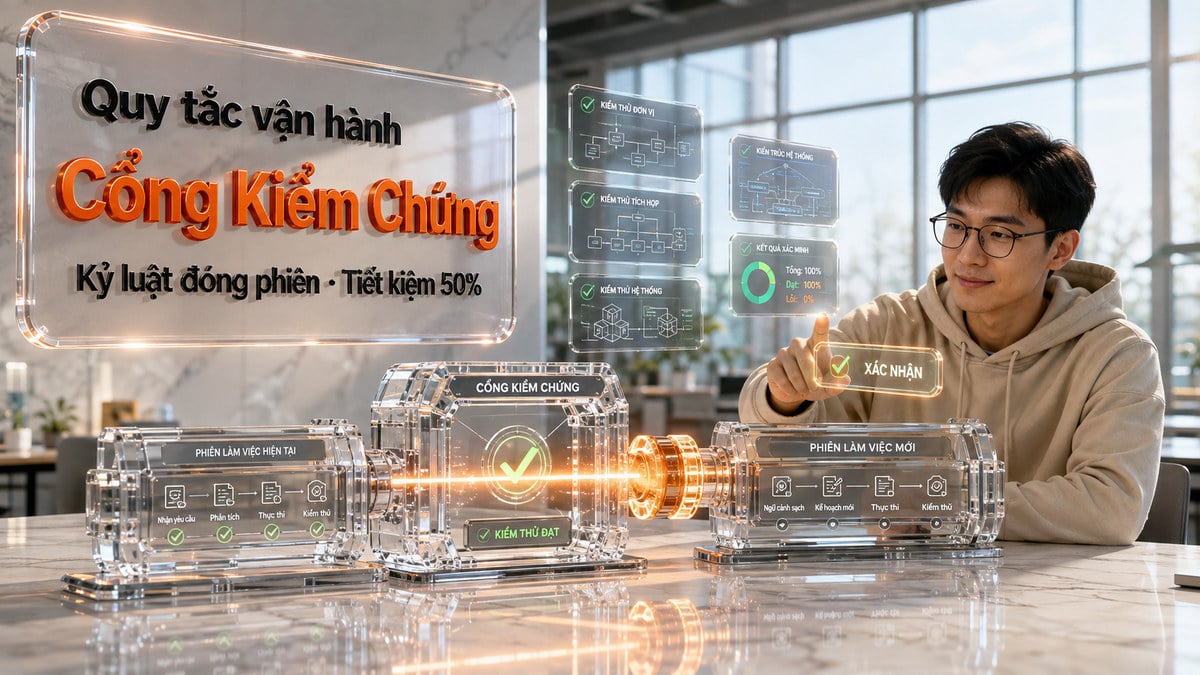
1. Kỷ luật đóng phiên đáng giá hơn việc chọn giao cho ai
Ở phiên 66abad03, việc giao viết code cho Gemini nhưng vẫn giữ nguyên phiên làm việc cũ để nghiệm thu chỉ giúp tiết kiệm 32% chi phí. Nhưng nếu cũng khối lượng công việc đó, bạn đóng phiên cũ lại sau khi giao bài và mở một phiên hoàn toàn mới để review, mức tiết kiệm vọt lên tới 50% (ở phiên 32173a05 mức tiết kiệm tăng từ 14% lên 44%).
Hơn một nửa phần chi phí tiết kiệm được đến từ việc bỏ đi 200k context tích luỹ không còn cần thiết, chứ không phải đến từ việc Gemini viết code thay Claude. Khi bản giao việc đã được viết xong, toàn bộ ký ức về quá trình đọc file và khảo sát ban đầu biến thành một gánh nặng chi phí thuần tuý — mỗi lượt gọi sau đó đều phải trả tiền để chở theo khối ký ức đó.
Dưới đây là bảng mô phỏng chi phí nếu cả hai phiên cuối đều được bàn giao cho Gemini theo các kịch bản quản lý context:
| Kịch bản phân chia công việc | Phiên 32173a05 | Phiên 66abad03 | Mức tiết kiệm |
|---|---|---|---|
| Thực tế — Claude tự triển khai toàn bộ | $23,26 | $32,41 | 0% (Gốc) |
| Viết pack cho Gemini, nghiệm thu ngay trong phiên cũ | $20,05 | $22,00 | 14% / 32% |
| Viết pack cho Gemini, đóng phiên, nghiệm thu ở phiên mới | $13,06 | $16,08 | 44% / 50% |
| Đóng phiên + giao phần khảo sát rộng ban đầu cho subagent | — | ~$12,70 | ~61% |
2. Claude đã tự đánh giá sai bài toán vì đo nhầm thước
Vào lúc 16:07 ngày 28 tháng 8, khi cân nhắc điều kiện "chỉ giao việc nếu tiết kiệm hơn 20%", Claude đã kết luận: "Viết pack đủ chính xác cho phần này gần bằng tự làm, nên tôi triển khai trực tiếp cả đợt A và B."
Kết luận đó chỉ đúng nếu nghiệm thu diễn ra ngay trong phiên cũ (chỉ tiết kiệm 14%, dưới ngưỡng 20%), nhưng hoàn toàn sai nếu đóng phiên (tiết kiệm tới 44%). Lý do Claude phán đoán sai là vì nó so sánh độ dài bản đặc tả so với độ dài code — tức là so sánh bằng output token, khoản chỉ chiếm 16% hoá đơn. Yếu tố quyết định 73% hoá đơn là số lượt gọi nhân với context, và ở bài toán đó, viết pack để mở phiên mới luôn là bên chiến thắng áp đảo.
3. Nghiệm thu đắt hơn giao việc
Số liệu đo được cho thấy: kiểm tra bài làm của Gemini tốn 4,47 đô la (56 lượt gọi), trong khi viết bản giao việc WO-4 tiếp theo chỉ tốn 1,46 đô la (7 lượt gọi).
Khi lên kế hoạch ngân sách và phân bổ thời gian cho mô hình thuê bao hay API trong vibe coding, phần nghiệm thu — chứ không phải phần viết tài liệu giao việc — mới là khoản chi phí lớn nhất bạn cần dự trù.
6. Bốn quy tắc vận hành rút ra từ bảng đo
Những dữ liệu đo đạc thực tế trên đã được đúc kết thành bốn nguyên tắc vận hành cốt lõi:
- Phân việc theo tính kiểm chứng, không theo độ khó (Verifiability Gate): Phần việc nào mà trạng thái "hoàn thành" kiểm tra được bằng một lệnh chạy — test xanh, typecheck sạch, lint qua, schema hợp lệ, script exit 0 — thì giao đi, bất kể khối lượng lớn hay tẻ nhạt đến đâu. Phần việc nào cần đến sự phán đoán — kiến trúc, bảo mật, mô hình dữ liệu, phân biệt lỗi app hay lỗi test — thì bắt buộc giữ lại.
- Đóng phiên ngay sau khi bàn giao bản giao việc: Nghiệm thu ở một phiên mới tinh chỉ cần bản spec, bản
git diffvà kết quả chạy lệnh kiểm chứng — tiêu tốn khoảng 55k context thay vì phải chở 250k–360k context từ phiên cũ. - Đẩy phần khảo sát rộng cho subagent: Ở phiên
66abad03, 66 lượt grep và đọc file để tìm hiểu mã nguồn đã tốn tới 6,94 đô la — bằng một nửa toàn bộ chi phí triển khai. Việc giao khảo sát cho subagent giúp trả về một bản tóm tắt súc tích và giữ context chính ở mức ~90k thay vì 207k, làm giảm chi phí cho tất cả các lượt gọi phía sau. - Ước lượng chi phí bằng số lượt gọi nhân context trung bình: Tuyệt đối không ước lượng chi phí bằng số dòng code hay số từ viết ra. Số lượt gọi nhân với kích thước context trung bình mới là công thức thực tế định đoạt hoá đơn của bạn.
Giới hạn của những con số trong bài
Mọi con số trong bài viết này được trích xuất trực tiếp từ 5 file transcript .jsonl của 5 phiên Claude Code trên dự án nội bộ aup-sourcing-ai trong hai ngày 27 và 28 tháng 8 năm 2026, được khử trùng lặp theo message.id và quy đổi theo biểu giá niêm yết của Claude Opus 5 ($5 / $25 / $6.25 / $0.50 cho mỗi triệu token input / output / cache write / cache read).
Những con số đô-la trong bài đóng vai trò là thước đo chuẩn hoá (benchmark) giúp bạn dễ dàng so sánh định lượng mức độ tiêu tốn tài nguyên giữa các phương án phân chia công việc và quản lý context. Với quy mô 5 phiên làm việc thực tế trên một dự án, các con số đủ để chứng minh quy luật cơ học của context và số lượt gọi API, nhưng không dùng để suy rộng thành mức trung bình của mọi mô hình dự án khác nhau. Bảng số đo trên repo my-website — nơi phần lớn bài khác trong chuỗi này lấy số — nằm ở bài tổng hợp số liệu gốc.
Bảng đo này chỉ có cột Claude. Câu hỏi hiển nhiên tiếp theo — phía Gemini tốn bao nhiêu — hồi đó tôi bỏ ngỏ, và sau này khi đo lại toàn bộ repo nguyenxuantai.com tôi mới trả lời được một phần. Claude Code trên repo đó tiêu 946.786.932 token qua 62 phiên, Codex tiêu 437.691.606 token qua 29 phiên, cả hai đều là số đo thẳng từ nhật ký. Còn Antigravity, nơi Gemini chạy, lưu hội thoại dưới dạng cơ sở dữ liệu mã hoá và không ghi một trường token nào, nên tôi chỉ đếm được 5.874 lượt gọi rồi ước ra khoảng 806 triệu đến 1.152 triệu token. Con số đó là ước tính, không phải số đo, và tôi để nguyên nó ở dạng một khoảng thay vì chốt một con số cho gọn.
Số liệu đầy đủ của cả ba công cụ nằm ở bảng gốc đã dẫn phía trên, còn thứ tự đọc cả chuỗi thì ở bản đồ ba tầng quyết định.